在数据系统的残酷现实中,许多事情可能出错:
事务 transaction 一直是简化这些问题的首选机制,应用程序通过事务将多个读写操作组合成一个逻辑单元。
从概念上讲,事务中的所有读写被当作一次操作执行:整个事务要么成功(提交,commit),要么失败(中止,abort;回滚,rollback)。如果失败,应用程序可以安全重试。有了事务,应用程序的错误处理就简单多了,因为它不必担心部分失效——即无论出于何种原因,有些操作成功、有些操作失败。
人们创造事务自由其目的,简化 访问数据库的 应用编程模型(programming model)。有了事务,应用程序便可以不去考虑某些潜在的错误场景和并发问题,因为数据库会代为处理这些问题(我们称之为 安全保证,safety guarantee)。
并非所有应用程序都需要事务,有时弱化事务保证,甚至彻底放弃事务也有好处。
几乎所有关系型数据库和一部分非关系型数据库都支持事务。
NoSQL 分布式数据库的炒作催生了观点:事务从根本上无法伸缩,任何大规模系统若想保持良好性能和高可用性,都必须放弃事务。近来事实已经证明这种观点是错误的。
CockroachDB、TiDB、Spanner、FoundationDB 和 YugabyteDB 等所谓的 “NewSQL” 数据库表明,事务系统同样可以扩展到很大的数据量和很高的吞吐量。这些系统将分片与共识协议结合起来,从而在大规模场景下提供强 ACID 保证。
事务提供的安全保证,通常用众所周知的首字母缩略词 ACID 来描述,分别代表 原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和 持久性(Durability)。
不符合 ACID 标准的系统有时称为 BASE,即 基本可用 Basically Available、软状态 Soft State 和 最终一致性 Eventual Consistency。
ACID 的原子性描述的是另一类情况:客户端想执行多次写入,却在其中一些写入处理完毕后遇到故障——例如进程崩溃、网络连接中断、磁盘空间耗尽,或者违反了某项完整性约束。如果这些写入被组合到一个原子事务中,而故障使事务无法完成(提交),那么事务就会 中止,数据库必须丢弃或撤销该事务此前完成的所有写入。
如果没有原子性,在多项变更执行到一半时发生错误,应用程序很难知道哪些变更已经生效、哪些尚未生效。它可以再试一次,却可能把同一项变更执行两遍,造成重复或错误的数据。原子性简化了这个问题:如果事务已经中止,应用程序便能确定它没有改变任何内容,因此可以安全重试。
遇到错误时中止事务,并丢弃该事务的所有写入,正是 ACID 原子性的定义性特征。或许称为 可中止性(abortability)比 原子性 更贴切。
一致性 这个词被严重滥用:
ACID 一致性的基本思想是:关于数据的某些陈述(即 不变式,invariant)必须始终成立。例如,在会计系统中,所有账户的贷记与借记必须始终相抵。如果事务开始时数据库满足这些不变式,事务中的所有写入又能维持其有效性,就可以确信不变式始终成立。(不变式在事务执行期间可以暂时被打破,但到事务提交时必须重新得到满足。)
如果希望由数据库强制执行不变式,就需要把它们声明为模式中的 约束(constraint)。外键约束、唯一性约束或检查约束(限制单行中可以出现的值)常用来表达特定类型的不变式。更复杂的一致性要求有时也可以用触发器或物化视图来表达。
不过,数据库通常提供的约束可能很难、甚至根本无法表达复杂的不变式。此时,应用程序就有责任正确定义事务,使其维持一致性。如果应用写入了违反不变式的错误数据,却没有事先声明这些不变式,数据库也无从阻止。因此,ACID 中的 C 往往取决于应用程序如何使用数据库,并非数据库自身的属性。
大多数数据库都会同时接受多个客户端的访问。如果各客户端读写数据库的不同部分,自然没有问题;但如果它们访问相同的数据库记录,就可能遇到并发问题(竞态条件)。
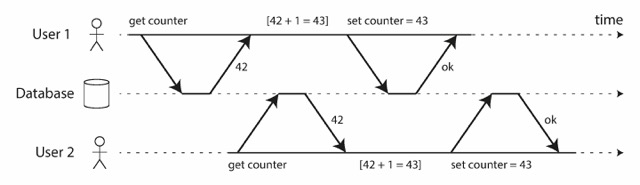
给出了这类问题的一个简单例子。假设两个客户端同时递增数据库中的一个计数器。每个客户端都要读取当前值,将其加 1,再把新值写回去(假设数据库没有内置的递增操作)。在图中,计数器经过两次递增,本应从 42 变成 44,却因竞态条件最终只变成了 43。
ACID 意义上的 隔离性 是指并发执行的事务彼此隔离,不能相互干扰。经典数据库教科书将隔离性形式化为 可串行化 :每个事务都可以假装自己是整个数据库中唯一正在运行的事务。数据库保证,所有事务提交后的结果与它们 串行 运行(逐个运行)的结果相同,尽管实际上这些事务可能是并发执行的。
然而,可串行化是有性能代价的。实践中,许多数据库采用弱于可串行化的隔离形式,也就是允许并发事务在有限范围内相互干扰。一些流行数据库(例如 Oracle)甚至没有实现可串行化:Oracle 虽有一个名为“可串行化”的隔离级别,实际实现的却是保证更弱的 快照隔离。
数据库系统的目的,是提供一个可以放心存放数据而无须担心丢失的安全场所。持久性 作出这样的承诺:事务一旦成功提交,其写入的任何数据都不会遗失,即使发生硬件故障或数据库崩溃也不例外。
在单节点数据库中,持久性通常意味着数据已经写入硬盘或 SSD
等非易失性存储。普通文件写入通常会先在内存中缓冲,稍后才送往磁盘,突然断电时便可能丢失;因此,许多数据库使用
fsync()
系统调用,确保数据确实已经落盘。数据库通常还有预写日志或类似机制,以便在写入中途崩溃后恢复。
在复制数据库中,持久性可能意味着数据已经成功复制到一定数量的节点。数据库必须等到这些写入或复制操作完成,才能报告事务已成功提交。不过,完美的持久性并不存在:如果所有硬盘和备份同时被毁,数据库显然也无能为力。
在 ACID 中,原子性和隔离性描述了客户端在同一事务中进行多次写入时,数据库应当如何处理:
原子性:
如果一系列写入执行到一半时发生错误,事务就应中止,之前完成的写入也应丢弃。
隔离性:
并发运行的事务不应相互干扰。例如,一个事务进行了多次写入,另一个事务就应当要么看到全部写入,要么一项也看不到,而不能只看到其中一部分。
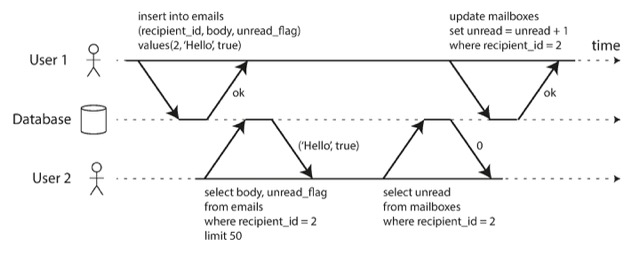
插入一条新邮件,然后将未读数量标记加 1。隔离性可以防止这个问题:它保证用户 2 要么同时看到新插入的邮件和更新后的计数,要么两者都看不到,而不会看到不一致的中间状态。
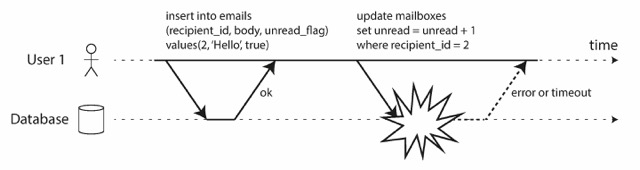
如果事务进行到一半时发生错误,邮箱内容和未读计数可能失去同步。在原子事务中,如果计数器更新失败,事务就会中止,已经插入的邮件也会回滚。
在关系型数据库中,这通常以客户端到数据库服务器的 TCP
连接为依据:同一条连接上,BEGIN TRANSACTION 与
COMMIT 语句之间的所有操作都属于同一个事务。如果 TCP
连接中断,事务就必须中止。
许多非关系型数据库并没有这种组合操作的机制。即便提供了多对象
API(例如键值存储可能提供一次更新多个键的 multi-put
操作),也不一定具备事务语义:命令可能只更新了其中一些键,另一些却失败了,使数据库停留在部分更新的状态。
原子性和隔离性也适用于单个对象的变更。例如,假设你正在向数据库写入一份 20 KB 的 JSON 文档:
几乎所有存储引擎都力求在单个节点的单个对象(例如键值对)层面提供原子性和隔离性。原子性可以通过日志和崩溃恢复来实现,隔离性则可以通过为每个对象加锁来实现(同一时刻只允许一个线程访问对象)。
有些数据库还提供更复杂的原子操作,例如递增操作,从而不必执行图 8-1 中的 读取—修改—写入循环。同样常见的还有 条件写入:只有当该值未被其他人并发修改时,写入才会发生(条件写入 比较并设置)。它类似于共享内存并发中的比较并设置或比较并交换(CAS)操作。
这些单对象操作很有用,因为它们能避免多个客户端同时写入同一对象时发生丢失更新)。但它们并不是通常意义上的事务。例如,Cassandra 和 ScyllaDB 的“轻量级事务”功能,以及 Aerospike 的“强一致性”模式,都能在单个对象上提供线性一致的读取和条件写入,却不为多个对象之间的操作提供保证。
真的需要多对象事务吗?能否只靠键值数据模型和单对象操作来实现任何应用程序?
有些用例只需插入、更新或删除单个对象就足够了。但在许多其他场景中,必须协调对多个不同对象的写入:
这类应用即使没有事务也能实现,不过没有原子性,错误处理就会复杂很多;缺少隔离性,又可能引发并发问题。
事务的一个关键特性是:遇到错误时,可以中止并安全重试。ACID 数据库遵循这样的原则:只要原子性、隔离性或持久性保证有遭到破坏的风险,数据库宁可彻底放弃事务,也不会让它停留在半完成状态。
不过,并非所有系统都遵循这一原则。尤其是采用 无主复制的数据存储 ,更多是以“尽力而为”的方式工作。概括来说就是:“数据库能做多少便做多少;如果遇到错误,也不会撤销已经完成的操作。”因此,从错误中恢复成了应用程序的责任。
错误不可避免,许多软件开发者却宁愿只考虑一切顺利的正常路径,不愿面对错误处理的复杂细节。例如,Rails 的 ActiveRecord 和 Django 等流行的对象关系映射(ORM)框架都不会重试已中止的事务,错误通常会以异常的形式沿调用栈向上传播,于是用户输入被丢弃,只收到一条错误消息。这很可惜,因为中止的意义恰恰在于允许安全重试。
尽管重试已中止的事务是一种简单有效的错误处理机制,却并非完美无缺:
如果两个事务不访问相同的数据,或者两者都是只读事务,它们就可以安全地并行运行,因为彼此并无依赖。只有当一个事务读取的数据正被另一个事务并发修改,或者两个事务试图同时修改相同数据时,才会出现并发问题(竞态条件)。
并发缺陷很难通过测试发现,因为它们只有在时序碰巧不利时才会触发。这种时序问题可能极少发生,通常也难以重现。并发行为本身同样难以推理,尤其是在大型应用中,你未必知道还有哪些代码正在访问数据库。即使每次只有一个用户,应用开发也已经不容易;面对许多并发用户则更为困难,因为任何数据都可能随时发生意料之外的变化。
正因如此,数据库长期以来一直试图通过 事务隔离(transaction isolation) 向应用开发者隐藏并发问题。理论上,隔离让你可以假装并发根本不存在:可串行化 隔离意味着,数据库保证事务产生的效果与 串行 运行(即逐个运行、毫无并发)相同。
实践中的隔离并没有这么简单。可串行化隔离有性能代价,许多数据库不愿为此买单。因此,系统普遍采用较弱的隔离级别,只防范 一部分 而非全部并发问题。这些隔离级别更难理解,也可能引发微妙的错误,却仍在实践中广泛使用。
弱事务隔离导致的并发缺陷绝非纸上谈兵:它们曾造成巨额资金损失,招致财务审计人员介入调查,也曾破坏客户数据。这类问题曝光后,人们常会说:“处理财务数据就该使用 ACID 数据库!”但这没有抓住要害。即使是许多通常被视为“ACID”的流行关系型数据库,也采用弱隔离,因而未必能防止这些问题。
即使并发问题在正常运行中很少发生,也必须考虑攻击者向 API 刻意发送一波高度并发的请求,专门利用并发缺陷的可能性。因此,要构建可靠且安全的应用,就必须系统性地防范这类缺陷。
最基本的事务隔离级别是 读已提交(read committed) ,它提供两项保证:
有些数据库还支持更弱的 读未提交 隔离级别。它能防止脏写,却不能防止脏读。下面详细讨论这两项保证。
设想一个事务已经向数据库写入数据,却尚未提交或中止。另一个事务能否看到这些未提交的数据?如果能,这就是 脏读。
运行在读已提交隔离级别下的事务必须防止脏读。这意味着,一个事务的所有写入都要等到该事务提交时,才会同时对其他事务可见。
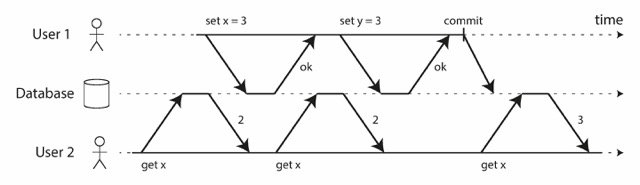
防止脏读有以下几个好处:
如果两个事务并发更新数据库中的同一行,会发生什么?写入次序虽然无法预知,但我们通常认为后一次写入会覆盖前一次写入。
可是,如果前一次写入属于尚未提交的事务,后一次写入覆盖了这个未提交值,又会怎样?这就是 脏写。运行在读已提交隔离级别下的事务必须防止脏写;通常的做法是推迟第二次写入,直到执行第一次写入的事务提交或中止。
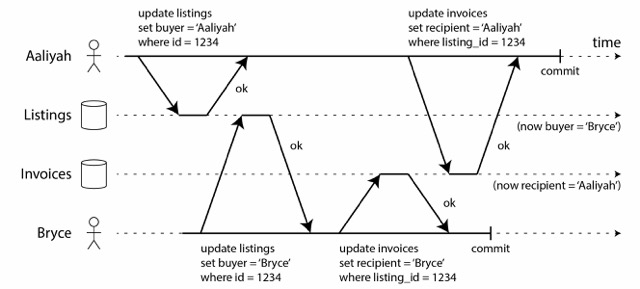
读已提交是一种非常流行的隔离级别,也是 Oracle Database、PostgreSQL、SQL Server 等许多数据库的默认设置。
数据库 防止脏写 最常见的办法是使用 行级锁 :事务想修改某一行(或文档等其他对象)时,必须先取得该行的锁,并一直持有到事务提交或中止。任何一行在同一时刻只能由一个事务持锁;另一个事务若想写入同一行,就必须等前一个事务提交或中止后,才能取得锁并继续执行。在读已提交模式(或更强的隔离级别)下,数据库会自动完成这些加锁操作。
那么怎样 防止脏读 ?一种办法仍是使用同一把锁:要求任何想读取某行的事务都短暂取得该锁,读完后立即释放。这样,当该行包含未提交的脏值时就无法读取,因为执行写入的事务仍持有这把锁。
然而,要求读操作加锁在实践中效果不佳。一个长期运行的写事务,可能迫使许多只读事务一直等到它结束。这不仅损害只读事务的响应时间,也不利于可运维性:应用某个部分一旦变慢,等待锁便可能引发连锁反应,波及完全不相干的其他部分。
尽管如此,仍有一些数据库使用锁来防止脏读,例如 IBM Db2,以及将
read_committed_snapshot=off 的 Microsoft SQL Server。
更常见的防脏读办法:对于每一行写入,数据库同时保留旧的已提交值,以及当前持有写锁的事务写入的新值。该事务进行期间,其他事务读取这一行时只会得到旧值;等新值提交后,才改为读取新值,多版本并发控制 MVCC。
在读已提交,在这个隔离级别下,并发缺陷仍可能以许多方式出现。
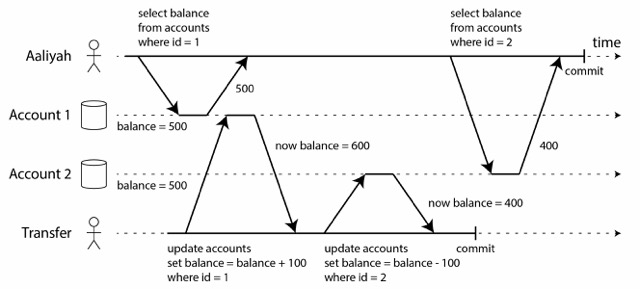
明明自己账户应该有1000元的,一查只有900,仿佛有100凭空消失了。
这种异常称为 读偏差(read skew),是 不可重复读(nonrepeatable read)的一种
备份:
备份需要复制整个数据库,大型数据库可能要花上几个小时。备份期间,数据库仍在不断接受写入。结果,备份的一部分可能包含较旧版本的数据,另一部分却包含较新版本。一旦从这样的备份恢复,原本暂时的不一致(例如凭空消失的钱)就会固化下来。
分析查询和完整性检查:
有时需要运行扫描数据库大部分内容的查询。如果查询在不同时间点观察数据库的不同部分,返回的结果很可能毫无意义。
快照隔离 是解决这个问题最常用的办法。其核心思想是,每个事务都从数据库的 一致快照 读取数据——也就是说,事务只看到它开始时数据库中已经提交的全部数据。即使其他事务后来修改了数据,它看到的仍是那个特定时刻的旧数据。
快照隔离对于备份、分析等长期运行的只读查询是一大福音。如果查询所处理的数据在执行期间不断变化,查询结果就很难解释;如果事务看到的是冻结在某个时刻的数据库一致快照,理解起来就容易多了。
快照隔离是一项常见功能:PostgreSQL、采用 InnoDB 存储引擎的 MySQL、Oracle、SQL Server 等数据库都支持它的某种变体,尽管各系统的具体行为有所不同。Oracle、TiDB 和 Aurora DSQL 等数据库甚至把快照隔离作为自身最高的隔离级别。
和读已提交一样,快照隔离通常用写锁来防止脏写。一个写事务可以阻塞另一个写入同一行的事务。不过,读取无须取得任何锁。
快照隔离的一项关键原则是:读不阻塞写,写也不阻塞读。
为实现快照隔离,数据库把防脏读机制推广开来。数据库不再只为每行保留两个版本(已提交版本,以及覆盖它但尚未提交的新版本),而是可能需要保留多个不同的已提交版本,因为正在运行的不同事务可能要观察数据库在不同时刻的状态。由于同一行的多个版本并存,这项技术称为 多版本并发控制(multi-version concurrency control,MVCC) 。
PostgreSQL 基于 MVCC 实现快照隔离,事务启动时获取一个唯一且单调递增的事务ID。 事务写入数据库的任何数据,都会以写入者的事务 ID 标记。
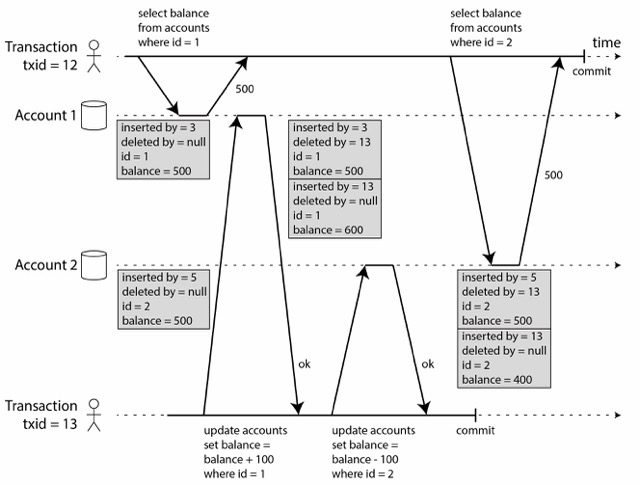
表中每一行都有一个 inserted_by
字段,保存将该行插入表中的事务 ID;还有一个初始为空的
deleted_by
字段。事务删除某行时,并不会立即将其从数据库中移除,而只是把
deleted_by 设为请求删除的事务
ID,以此标记删除。等到确定再也没有事务能访问这些已删除数据时,数据库的垃圾收集进程才会移除带删除标记的行并释放空间。
一行的所有版本都存放在同一个数据库堆中,不论写入它们的事务是否已经提交。同一行的 各个版本组成链表,可以从最新版本连到最旧版本,也可以反向连接,使查询能在内部遍历 该行的所有版本。
事务读取数据库时,系统根据事务 ID 判断哪些行版本可见、哪些不可见。只要审慎定义可见性规则,数据库就能向应用程序呈现一致快照。其工作方式大致如下:
这些规则即适用于插入行,也适用于删除行。
只有同时满足以下两个条件,一行才可见:
长期运行的事务可能一直使用同一个快照,继续读取在其他事务看来早已被覆盖或删除的值。数据库从不原地更新值,而是在每次变更时插入新版本,因而只需很小的开销就能提供一致快照。
多版本数据库中的索引如何工作?最常见的做法是,每个索引项指向与其匹配的某个行版本(最旧或最新版本)。每个行版本可以引用下一个更旧或更新的版本。使用索引的查询必须沿行版本遍历,找到既对当前事务可见、值又符合查询条件的那一行。垃圾收集移除不再对任何事务可见的旧行版本时,也可以一并删除相应的索引项。
许多实现细节都会影响多版本并发控制的性能。例如,如果同一行的不同版本可以容纳在同一个页面中,PostgreSQL 会通过优化避免更新索引。另一些数据库则不保存修改后行的完整副本,只保存版本间的差异以节省空间。
CouchDB、Datomic 和 LMDB 采用另一种方法。它们同样使用 B 树,但采用 不可变(写时复制)的变体:更新时不覆盖树页面,而是为每个被修改的页面创建新副本。从其父页面一直到树根,也都会复制并更新,以指向新版子页面。未受写入影响的页面无须复制,可由新树继续共享。
采用不可变 B 树时,每个写事务(或一批事务)都会创建一个新的 B 树根;某个特定的树根,就是它创建时数据库的一致快照。由于后续写入无法修改现有 B 树,只能创建新的树根,因此无须根据事务 ID 过滤行。这种方法同样需要后台进程执行压缩和垃圾收集。
MVCC 是数据库常用的实现技术,也经常用来实现快照隔离。不过,不同数据库有时会用不同术语指代同一件事:例如,快照隔离在 PostgreSQL 中称为“可重复读(repeatable read)”,在 Oracle 中称为“可串行化”。反过来,不同系统也会用同一个术语表示不同事物:PostgreSQL 的“可重复读”指快照隔离,MySQL 的“可重复读”却是一个一致性弱于快照隔离的 MVCC 实现。
SQL 标准对隔离级别的定义存在缺陷:含糊、不精确,也没有做到标准理应具备的实现无关性。好几种数据库都声称实现了可重复读,实际提供的保证却相去甚远,尽管它名义上已经标准化。
并发写事务之间还可能出现其他几类值得关注的冲突,其中最著名的便是 丢失更新(lost update)。
应用程序从数据库读取一个值,修改后再写回去,这个过程称为 读取—修改—写入循环(read-modify-write cycle),可能发生丢失更新。如果两个事务并发执行这样的循环,其中一项修改可能丢失,因为后一次写入没有包含前一个事务的修改。(有时也说后一次写入 抹掉 了前一次写入。)这种模式会出现在许多场景中:
许多数据库提供 原子写操作(atomic write operation),使应用程序不必自行实现读取—修改—写入循环。
UPDATE counters SET value = value + 1 WHERE key = 'foo';类似地,MongoDB 等文档数据库提供原子操作,供应用局部修改 JSON 文档;Redis 则提供修改优先队列等数据结构的原子操作。
原子操作通常这样实现:读取对象时取得 排他锁(exclusive lock),使其他事务在更新完成之前无法读取该对象。另一种办法则是强制所有原子操作都在单个线程上执行。
对象关系映射(ORM)框架很容易让人无意中写出不安全的读取—修改—写入循环,而没有使用数据库提供的原子操作。由此产生的缺陷往往十分隐蔽,很难通过测试发现。
如果数据库内置的原子操作无法满足需求,还可以由应用程序 显式锁定(explicit locking)即将更新的对象,再执行读取—修改—写入循环。其他事务若试图并发更新或锁定同一对象,就必须等前一个循环完成。
BEGIN TRANSACTION;

SELECT * FROM figures
    WHERE name = 'robot' AND game_id = 222
    FOR UPDATE;

-- FOR UPDATE 子句表示数据库应当锁定这条查询返回的所有行。

-- 检查移动是否有效,然后更新
-- 前一个 SELECT 返回的棋子的位置。
UPDATE figures SET position = 'c4' WHERE id = 1234;

COMMIT;
锁定多个对象会带来死锁风险,两个或更多事务彼此等待对方释放锁,许多数据库会自动检测死锁,并中止其中一个事务,让系统得以继续推进,应用程序只需重试这个被中止的事务即可。
原子操作和锁通过强制读取—修改—写入循环依次执行来防止丢失更新。另一种思路是允许这些循环并行执行;事务管理器一旦检测到丢失更新,便中止相应事务,迫使它重试整个循环。
这种方法的一项优势是,数据库可以结合快照隔离高效完成检查。事实上,PostgreSQL 的可重复读、Oracle 的可串行化和 SQL Server 的快照隔离,都会自动检测丢失更新并中止发生冲突的事务。
MySQL/InnoDB
的可重复读则不会检测丢失更新。一些作者认为,数据库只有能够防止丢失更新,才算提供快照隔离;按照这个定义,MySQL
并没有提供快照隔离。
自动检测丢失更新是一项很实用的功能,因为应用代码无须使用任何特殊数据库功能。开发者可能忘记加锁或使用原子操作而引入缺陷,自动检测则不容易遗漏。不过,应用程序仍须负责重试被中止的事务。
不提供事务的数据库有时会提供 条件写入 操作。只有当值自上次读取后未发生变化,才允许更新,从而防止丢失更新。如果当前值与先前读到的值不符,更新便不生效,应用必须重试读取—修改—写入循环。它相当于数据库版本的原子 比较并设置(compare-and-set)或 比较并交换(compare-and-swap,CAS)指令,许多 CPU 都支持此类指令。
-- 这可能安全也可能不安全,取决于数据库实现
UPDATE wiki_pages SET content = 'new content'
WHERE id = 1234 AND content = 'old content';在复制数据库中,防止丢失更新又多了一个维度:数据副本分布在多个节点上,并可能在不同节点被并发修改,因此还需采取额外措施。
锁和条件写入操作都假定存在唯一的最新数据副本。但采用多主复制或无主复制的数据库,通常允许多项写入并发发生,再异步复制到其他节点,因而无法保证存在唯一的最新副本。所以,基于锁或条件写入的技术并不适用于这种场景。
这类复制数据库通常采用另一种办法,允许并发写入产生同一个值的多个冲突版本(也称为 兄弟值,siblings),再由应用代码或特殊数据结构事后解决冲突并合并版本。
如果更新是可交换的——即在不同副本上按不同顺序应用,仍会得到相同结果——那么合并冲突值便可防止丢失更新。递增计数器、向集合添加元素都是可交换操作。这正是“CRDT 与操作变换”介绍的 CRDT 背后的思想。不过,条件写入等操作无法变成可交换操作。
另一方面,最后写入者胜(LWW)这种冲突解决办法很容易丢失更新,详见“最后写入者胜(丢弃并发写入)”。遗憾的是,许多复制数据库都默认采用 LWW。
你正在编写一款供医生管理医院值班安排的应用。医院通常希望任何时候都有几位医生值班,但底线是至少必须有一位。医生可以放弃自己的班次(例如本人也生病了),前提是同一班次至少还有一位同事继续值班。
假设某个班次只有 Aaliyah 和 Bryce 两位值班医生。两人都身体不适,决定请假,偏偏又几乎同时点击了退出值班的按钮。接下来发生的事情
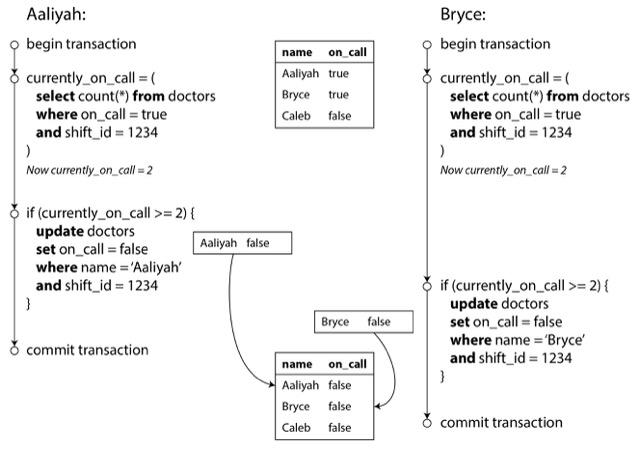
由于数据库采用快照隔离,两次检查都返回 2,两个事务于是都进入下一阶段。Aaliyah 更新自己的记录,退出值班;Bryce 也作出同样的更新。两个事务都成功提交,结果却没有任何医生值班,违反了“至少一位医生值班”的要求。
这种异常称为 写偏差(write skew) 。它既不是脏写,也不是丢失更新,因为两个事务更新的是不同对象——分别是 Aaliyah 和 Bryce 的值班记录。这里的冲突不那么明显,却确实是一种竞态条件:如果两个事务依次运行,第二位医生就无法退出值班。只有并发执行事务,才会出现这种异常行为。
可以把写偏差看作丢失更新的推广:两个事务读取相同的一组对象,随后各自更新其中一些对象(不同事务可以更新不同对象),就可能发生写偏差。若不同事务碰巧更新同一个对象,则会表现为脏写或丢失更新,具体取决于时序。
防止丢失更新的办法有很多,处理写偏差时可选手段却少得多:
PostgreSQL 的可重复读、MySQL/InnoDB 的可重复读、Oracle 的可串行化以及
SQL Server 的快照隔离,都不会自动检测写偏差。要自动防止写偏差,必须采用真正的可串行化隔离。BEGIN TRANSACTION;
SELECT * FROM doctors
WHERE on_call = true
AND shift_id = 1234 FOR UPDATE;
-- FOR UPDATE 要求数据库锁定这条查询返回的所有行
UPDATE doctors
SET on_call = false
WHERE name = 'Aaliyah'
AND shift_id = 1234;
COMMIT;会议室预订系统:
假设你要保证同一间会议室在同一时段不能被重复预订。有人发起预订时,先检查是否存在冲突(即同一房间是否有时间范围重叠的预订);若没有,再创建会议。
BEGIN TRANSACTION;

-- 检查是否有任何现有预订与中午 12 点到 1 点的时间段重叠
SELECT COUNT(*) FROM bookings
WHERE room_id = 123 AND
end_time > '2025-01-01 12:00' AND start_time < '2025-01-01 13:00';

-- 如果前一个查询返回零:
INSERT INTO bookings (room_id, start_time, end_time, user_id)
VALUES (123, '2025-01-01 12:00', '2025-01-01 13:00', 666);

COMMIT;
遗憾的是,快照隔离无法阻止另一个用户并发插入冲突的会议。要保证安排不会冲突,还是得采用可串行化隔离。
多人游戏:
用锁防止丢失更新,也就是确保两名玩家不能同时移动同一个棋子。但这把锁无法阻止玩家把两个不同棋子移动到棋盘上的同一位置,也无法阻止其他违反规则的走法。视具体规则而定,有时可以使用唯一性约束;否则就很容易发生写偏差。
声明名用户:
在要求用户名唯一的网站上,两个用户可能同时尝试用同一个名字创建账户。可以用事务先检查用户名是否已被占用,如果没有,再用它创建账户。但和前面的例子一样,这在快照隔离下并不安全。好在唯一性约束就能轻松解决这个问题:第二个尝试注册该用户名的事务会因违反约束而中止。
防止重复消息:
允许用户消费金钱或积分的服务,必须确保用户的支出不超过余额。一种实现方式是先在用户账户中插入暂定支出项,再列出账户中的所有项目,检查合计余额是否仍为正数。发生写偏差时,两个支出项可能被并发插入,合在一起使余额变成负数,两个事务却都没有察觉对方。
这些例子都遵循相似的模式:
这次写入改变了步骤 2 作出决定时所依据的前提。换句话说,写入提交后再次执行步骤 1 的 SELECT,结果就会不同,因为符合搜索条件的行集合已经改变(少了一位值班医生、会议室在该时段已有预订、棋盘上的目标位置已被刚移入的棋子占据、用户名已被占用,或账户余额已经减少)。
这些步骤也可以采用不同顺序。例如,可以先写入,再执行 SELECT 查询,最后根据查询结果决定中止还是提交。
一个事务的写入改变了另一个事务中搜索查询的结果,这种现象称为 幻读(phantom)。快照隔离可以避免只读查询中的幻读,但在上述读写事务中,幻读可能引发格外棘手的写偏差。ORM 生成的 SQL 也很容易遇到写偏差。
如果幻读的问题在于没有对象可供加锁,或许可以人为地在数据库中引入一个锁对象?
以会议室预订为例,可以创建一张房间与时段表。表中每一行对应某个房间的某个特定时段(例如 15 分钟),提前为未来六个月内所有可能的房间与时段组合建好行。
现在,创建预订的事务可以锁定 SELECT FOR UPDATE
表中与目标房间和时段对应的行。取得锁后,再照常检查重叠预订并插入新预订。请注意,这张附加表并不存储预订信息——它纯粹是一组锁,用来防止同一房间、同一时间范围内的预订被并发修改。
这种方法称为 物化冲突 materializing conflicts :它把幻读转化为数据库中一组具体行上的锁冲突。遗憾的是,怎样物化冲突既难设计又容易出错,而且让并发控制机制渗入应用数据模型也很不美观。因此,物化冲突只能在别无选择时作为最后手段;大多数情况下,可串行化隔离要好得多。
事务出现竞态条件,读已提交和快照隔离可以防止其中一部分,却无法防止其他类型,写偏差和幻读尤其棘手。
可串行化是最强的隔离级别。它保证即使事务实际并行执行,最终结果也与它们 串行 执行(逐个执行、毫无并发)相同。因此,只要事务单独运行时行为正确,数据库就能保证它们并发运行时仍然正确。换句话说,数据库可以防止 所有 可能的竞态条件。
避免并发问题最简单的办法,就是彻底消除并发:在单个线程上按照串行顺序,每次只执行一个事务。这样便完全绕开了检测和防止事务冲突的问题,而得到的隔离按定义就是可串行化的。
多线程并发一直被视为取得良好性能的必要条件,究竟是什么变化让单线程执行成为可能?
VoltDB/H-Store、Redis 和
Datomic
等系统采用了串行执行事务的方式。为单线程执行而设计的系统有时反而比支持并发的系统性能更好,因为它省去了加锁的协调开销。不过,其吞吐量受限于单个
CPU 核。要充分利用这条线程,事务的组织方式必须不同于传统形式。
数据库诞生之初,人们设想事务可以涵盖用户活动的整个流程。例如,预订机票要经过多个阶段:搜索航线、票价和空余座位;确定行程;预订每一段航班的座位;填写乘客信息;最后付款。数据库设计者认为,如果把整个流程作为一个事务原子提交,会非常理想。
遗憾的是,人类作出决定和响应的速度很慢。如果数据库事务要等待用户输入,数据库就必须支持数量可能极其庞大的并发事务,而且其中大部分都处于空闲状态。绝大多数数据库无法高效做到这一点,因此几乎所有 OLTP 应用都会避免在事务中交互等待用户,以保持事务简短。在 Web 应用中,这意味着事务要在同一个 HTTP 请求内提交,不能跨越多个请求;新的 HTTP 请求会启动新的事务。
单线程串行处理事务的系统不允许交互式多语句事务。应用要么只使用单语句事务,要么提前把整个事务的代码作为 存储过程(stored procedure) 提交给数据库。不然单线程的因为某个事务等待交互,直接把数据库阻塞了。
交互式事务与存储过程的差别如图所示。只要事务所需的全部数据都在内存中,存储过程就能快速执行,无须等待任何网络或磁盘 I/O。
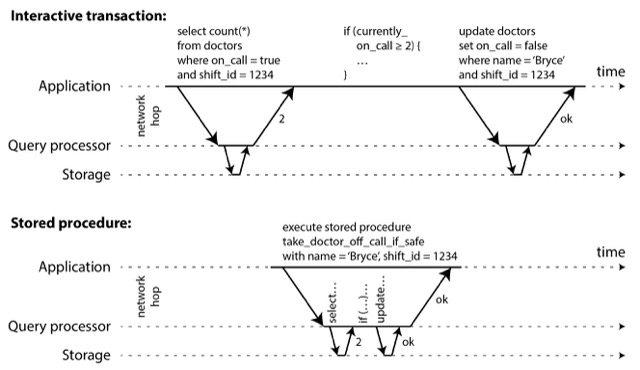
存储过程早就存在于关系型数据库中,从1999年就成为SQL标准的一部分。
Oracle
使用 PL/SQL,SQL Server 使用
T-SQL,PostgreSQL 使用 PL/pgSQL
等)。这些语言没有跟上通用编程语言的发展,今天看来颇为丑陋陈旧,也缺少大多数编程语言拥有的库生态。不过,这些问题并非无法克服。现代存储过程实现已经放弃
PL/SQL,转而采用现有的通用编程语言:VoltDB 使用 Java 或
Groovy,Datomic 使用 Java 或 Clojure,Redis 使用 Lua,MongoDB 使用
JavaScript。
存储过程配合内存数据,使所有事务都在单线程上执行成为可行方案。只要存储过程无须等待
I/O,又能避开其他并发控制机制的开销,单线程也可以达到相当可观的吞吐量。
VoltDB 还利用存储过程进行复制:它不把事务写入从一个节点复制到另一个节点,而是在每个副本上执行同一个存储过程。因此,VoltDB 要求存储过程必须是 确定性的(deterministic) ,即在不同节点运行时产生相同结果。例如,事务若要使用当前日期和时间,就必须通过特殊的确定性 API 获取。
串行执行所有事务大大简化了并发控制,却也把数据库的事务吞吐量限制在单台机器、单个 CPU 核的处理能力以内。只读事务可以通过快照隔离在别处执行;但对写入吞吐量很高的应用而言,单线程事务处理器可能成为严重瓶颈。
要扩展到多个 CPU 核和多个节点,可以像 VoltDB 那样对数据分片。如果能让每个事务只读写单个分片内的数据,那么每个分片都可以拥有自己的事务处理线程,彼此独立运行。此时可以为每个 CPU 核分配一个分片,使事务吞吐量随 CPU 核数线性增长。
但凡事务需要访问多个分片,数据库就必须在所有涉及的分片之间进行协调。存储过程要在这些分片上步调一致地执行,才能保证整个系统的可串行化。
跨分片事务有额外的协调开销,因此远慢于单分片事务。VoltDB 报告的跨分片写入吞吐量约为每秒 1,000 次,比单分片吞吐量低几个数量级,而且无法靠增加机器来提升。近来的研究探索了让多分片事务更具可伸缩性的办法。
事务能否限制在单个分片内,很大程度上取决于应用所用的数据结构。简单的键值数据通常很容易分片;具有多个二级索引的数据则很可能需要大量跨分片协调。
在满足特定约束的情况下,串行执行事务已经成为实现可串行化隔离的一种可行办法:
30年间,数据库领域只有一种得到广泛应用的可串行化算法:两阶段锁定(two-phase locking,2PL) 。它有时也称为 强严格两阶段锁定(strong strict two-phase locking,SS2PL) ,以区别于 2PL 的其他变体。
锁通常用于防止脏写,若两个事务并发写入同一对象,锁会迫使第二个写入者等待,直到第一个事务提交或中止后才能继续。
两阶段锁定与此类似,但加锁要求严格得多。只要没有写入,多个事务可以并发读取同一个对象;但只要有事务想写入(修改或删除)对象,就必须取得独占访问权:
在 2PL 中,写会阻塞其他写,也会阻塞读;反过来,读同样会阻塞写。快照隔离则奉行 “读不阻塞写,写也不阻塞读” 多版本并发控制(MVCC),这正是快照隔离与两阶段锁定的关键区别。另一方面,2PL 提供可串行化,能够防止前面讨论的所有竞态条件,包括丢失更新和写偏差。
MySQL(InnoDB)和 SQL Server 的可串行化隔离级别,以及 Db2 的可重复读隔离级别,都采用 2PL。
数据库通过为每个对象设置一把锁来阻塞读写操作。锁可以处于 共享模式(shared mode)或 独占模式(exclusive mode),这也称为 多读者单写者(multi-reader single-writer)锁。具体规则如下:
由于大量使用锁,很容易出现事务 A 等待事务 B 释放锁、事务 B 又反过来等待事务 A 的情况,这称为 死锁(deadlock) 。数据库会自动检测事务之间的死锁并中止其中一个,让其他事务能够继续推进;被中止的事务则由应用程序重试。
两阶段锁定最大的缺点,也是它自 20 世纪 70 年代以来始终没有普及到所有数据库的原因,就是性能:在两阶段锁定下,事务吞吐量和查询响应时间都明显逊于弱隔离。
这部分源于获取和释放大量锁的开销,更主要的原因则是并发度降低。按照设计,只要两个并发事务执行的操作有任何可能引发竞态条件,其中一个就必须等另一个完成。
例如,一个事务需要读取整张表,用于备份、分析查询或完整性检查,就必须为整张表取得共享锁,后面所有要写的事务都要等待了。
因此,采用 2PL 的数据库延迟可能相当不稳定;工作负载一旦存在争用,高百分位延迟就可能非常糟糕。仅仅一个慢事务,或者一个访问大量数据、取得许多锁的事务,就可能让系统其余部分陷入停顿。
基于锁的读已提交也会发生死锁,但在 2PL 可串行化隔离下,死锁往往更为频繁(具体取决于事务的访问模式)。这又会带来额外的性能问题:事务因死锁而中止、重试时,必须从头重做全部工作。若死锁频繁,浪费的计算量会相当可观。
幻读:一个事务改变了另一个事务的搜索查询结果。
提供可串行化隔离的数据库必须防止幻读。
谓词锁(predicate lock) ,它的工作方式类似前面介绍的共享锁和独占锁,却不属于某个特定对象(例如表中的一行),而是属于所有 符合某项搜索条件的对象,例如:
SELECT * FROM bookings
 WHERE room_id = 123 AND
 end_time > '2025-01-01 12:00' AND
 start_time < '2025-01-01 13:00';
谓词锁限制访问如下:
谓词锁甚至适用于数据库中尚不存在、未来却可能加入的对象(即幻读)。两阶段锁定若包含谓词锁,数据库就能防止各种形式的 写偏差和其他竞态条件,使隔离达到可串行化。
遗憾的是,谓词锁性能不佳:活跃事务持有大量锁时,检查是否有匹配的锁会非常耗时。因此,大多数采用 2PL 的数据库实际实现的是 索引范围锁(index-range lock,也称为 next-key locking) ,即谓词锁的一种简化近似。
把谓词放宽到匹配更大的对象集合,是一种安全的简化。例如,要锁定 123 号房间从中午 12 点到下午 1 点的预订,可以近似为锁定 123 号房间全天所有预订;也可以近似为锁定中午 12 点到下午 1 点所有房间的预订。这样做是安全的,因为任何符合原始谓词的写入,必然也符合近似后的条件。
比如,会议室预订数据库很可能在 room_id
列上建有索引,或在 start_time 和 end_time
上建有索引(否则前述查询面对大型数据库会非常慢):
room_id 上,数据库用它查找
123
号房间的现有预订。数据库可以直接把共享锁附加到这条索引项上,表示某个事务已搜索过
123 号房间的预订。无论采用哪种索引,搜索条件的近似都会附着在其中一个索引上。另一个事务若想插入、更新或删除同一房间和 或重叠时段的预订,就必须更新索引的同一部分,于是会碰到共享锁,被迫等到锁释放。
这样便能有效防止幻读和写偏差,索引范围锁不如谓词锁精确,可能会锁住比维持可串行化严格所需要更大范围的对象;但其开销低得多,是一种很好的折中。如果没有合适的索引可供附加范围锁,数据库可以退回到对整张表加共享锁。这样会阻塞所有其他事务写表,性能很差,却是安全的后备方案。
一边是性能不佳的两阶段锁定,以及伸缩性不佳的串行执行;
另一边是性能虽好,却容易出现丢失更新、写偏差、幻读等竞态条件的弱隔离。
一种名为 可串行化快照隔离(serializable snapshot isolation,SSI) 的算法能够提供完整的可串行化,与快照隔离相比只付出很小的性能代价。SSI 相对较新,最早于 2008 年提出。
SSI 及类似算法已经用于单节点数据库(PostgreSQL
的可串行化隔离级别、SQL Server 的内存 OLTP/Hekaton 和
HyPer)、分布式数据库(CockroachDB 和 FoundationDB),以及 BadgerDB
等嵌入式存储引擎。
两阶段锁定属于所谓的 悲观 pessimistic 并发控制机制。遵循这样的原则:只要有任何出错的可能(例如另一个事务持有锁),就先等待, 直到局面重新安全后再行动。这类似于 多线程编程 中用来保护数据结构的 互斥(mutual exclusion)。
串行执行把悲观推到了极致:本质上,每个事务在执行期间都像是对整个数据库(或一个数据库分片)持有独占锁。作为补偿,每个事务都要尽快执行,使这把“锁”只持有很短时间。
可串行化快照隔离是一种 乐观(optimistic)并发控制技术。这里的“乐观”是指:即使出现潜在危险,也不阻塞事务,而是让它继续运行,寄望最终不会出问题。等事务准备提交时,数据库再检查是否发生了坏事(即隔离是否遭到破坏);若有,就中止并重试事务。只有执行结果可串行化的事务才能提交。
乐观并发控制是个古老的思想,其利弊也已争论多年。存在严重争用(许多事务访问相同对象)时,它表现很差,因为很大比例的事务都不得不中止。若系统已经接近最大吞吐量,重试事务带来的额外负载还会进一步拖累性能。
如果系统有充足的余量,事务之间争用又不严重,乐观并发控制往往优于悲观方案。可交换的原子操作还能降低争用:例如,多个事务并发递增计数器时,应用这些增量的顺序无关紧要(只要同一事务没有读取该计数器),因此所有并发增量都可以执行而不会冲突。
SSI 建立在快照隔离之上:事务中的所有读取都来自数据库的一致快照。在此基础上,SSI 加入算法来检测读写之间的可串行化冲突,并决定应当中止哪些事务。
在隔离快照中写偏差时,反复看到一种模式:事务从数据库读取数据、检查查询结果,再根据结果决定执行某项操作(向数据库写入)。然而在快照隔离下,等事务提交时,原查询结果可能已经过时,因为数据在此期间可能被修改。
换句话说,事务根据某个 前提 行动 即事务开始时为真的事实,例如“当前有两名医生值班”。等到事务准备提交时,原始数据可能已经变化,原先的前提不再成立。
应用发出查询(例如“当前有多少医生值班?”)时,数据库并不知道应用逻辑会如何使用查询结果。为确保安全,数据库必须假定:查询结果(即前提)一有变化,该事务中的写入就可能失效。也就是说,事务中的查询与写入之间可能存在因果依赖。为了提供可串行化隔离,数据库必须检测事务是否可能依据过时前提行事,并在这种情况下中止事务。
数据库怎样判断查询结果可能已经变化?需要考虑两种情况:
回想一下,快照隔离通常通过多版本并发控制实现 MVCC,事务从MVCC数据库的一致快照读取时,会忽略其他事务在快照生成时尚未提交的所有写入。
事务 43 看到 Aaliyah 的 on_call = true,因为修改其值班状态的事务 42 尚未提交。但等事务 43 准备提交时,事务 42 已经提交。这意味着,读取一致快照时被忽略的写入现在已经生效,事务 43 的前提不再成立。如果写入者插入的是此前不存在的数据,情况还会更复杂
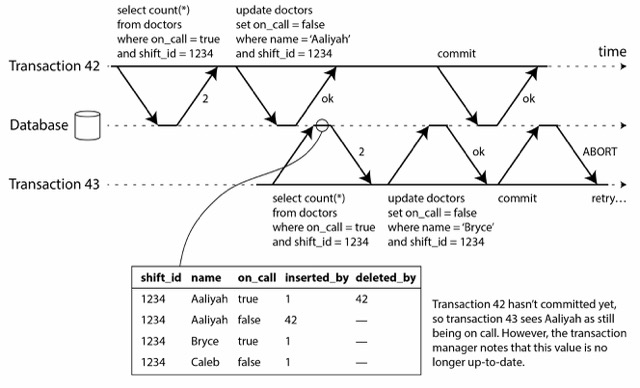
为防止这种异常,数据库必须跟踪事务何时因 MVCC 可见性规则而忽略了其他事务的写入。等事务准备提交时,再检查这些被忽略的写入是否已经提交;若是,就必须中止该事务。
为什么非要等到提交?为什么不在发现过时读取时立刻中止事务 43?如果事务 43 是只读事务,就没有写偏差风险,无须中止;而在它读取时,数据库还不知道它稍后是否会写入。此外,事务 42 可能最终中止,也可能在事务 43 提交时仍未提交,于是这次读取到头来并未过时。通过避免不必要的中止,SSI 保留了快照隔离支持长期读取一致快照的优点。
第二种情况,是数据被读取后又遭另一个事务修改:
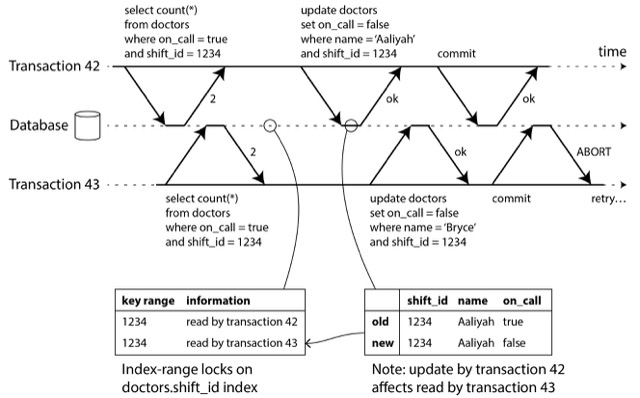
在讨论
两阶段锁定时,介绍过索引范围锁,数据库可以借此锁定所有符合某项查询条件的行,例如
WHERE shift_id = 1234 。SSI 可以使用类似技术,区别在于 SSI
的锁不会阻塞其他事务。
事务 42 和 43 都查询了班次 1234 的值班医生。如果 shift_id 上有索引,数据库就能利用索引项 1234 记录事务 42 和 43 读过这项数据。(没有索引时,也可以在表级别跟踪。)这些信息只需保留一段时间:等事务结束(提交或中止),并且所有与之并发的事务也结束后,数据库就可以忘掉它读过哪些数据。
事务写入数据库时,必须在索引中查找近期读过受影响数据的其他事务。这个过程类似为受影响的键范围取得写锁,但它不会一直阻塞到读事务提交,而是像警戒线一样:只负责通知相关事务,它们读过的数据可能已经过时。
事务 43 通知事务 42:它先前读过的数据已经过时;事务 42 也反过来通知事务 43。事务 42 率先提交并获得成功:虽然事务 43 的写入影响了事务 42,但事务 43 尚未提交,所以写入还未生效。等事务 43 准备提交时,事务 42 的冲突写入已经提交,因此事务 43 必须中止。
一如既往,许多工程细节会影响算法的实际表现。例如,需要权衡以多细的粒度跟踪事务读写。如果数据库详细记录每个事务的活动,就能精确判断哪些事务应当中止,但记账开销可能很大;较粗粒度的跟踪更快,却可能中止一些本来无须中止的事务。
有些情况下,事务读到被另一事务覆盖的信息也没有关系:结合其他事件,有时可以证明执行结果仍然可串行化。PostgreSQL 利用这一理论来减少不必要的中止。
与两阶段锁定相比,可串行化快照隔离的主要优势是:事务无须因等待另一个事务持有的锁而阻塞。与快照隔离一样,写不阻塞读,读也不阻塞写。这项设计原则让查询延迟更加可预测,波动也更小。尤其是只读查询可以无须任何锁、直接运行在一致快照上,对读取密集型工作负载很有吸引力。
与串行执行相比,可串行化快照隔离不受单个 CPU 核吞吐量的限制。例如,FoundationDB 把可串行化冲突检测分散到多台机器上,因而可以扩展到很高的吞吐量。即使数据分片存放在多台机器上,事务仍可读写多个分片,同时保证可串行化隔离。
与非可串行化的快照隔离相比,检查可串行化违规会带来一些性能开销。这项开销究竟有多大,仍有争议:有人认为可串行化检查得不偿失;也有人认为如今可串行化性能已经足够好,没必要再采用较弱的快照隔离。
中止率会显著影响 SSI 的总体性能。一个长期读写数据的事务很可能遇到冲突而中止,因此 SSI 要求读写事务相当短小(长期运行的只读事务没有问题)。不过,与两阶段锁定或串行执行相比,SSI 对慢事务没有那么敏感。
对于只在单个数据库节点上执行的事务,原子性通常由存储引擎实现。
对于只在单个数据库节点上执行的事务,原子性通常由存储引擎实现。客户端请求数据库节点提交时,数据库先将事务写入持久化 通常写入预写日志;再向磁盘日志追加一条提交记录。如果数据库在此过程中崩溃,节点重启后便从日志恢复事务:若提交记录在崩溃前已经成功落盘,事务视为已提交;否则,该事务的所有写入都会回滚。
在单节点上,事务能否提交,关键取决于数据持久化落盘的 顺序,先写数据,再写提交记录。决定事务提交还是中止的关键时刻,就是磁盘完成提交记录写入的一刻:在此之前,事务仍可能因崩溃而中止;在此之后,即使数据库崩溃,事务也已经提交。
如果事务涉及多个节点呢?例如,分片数据库中可能有多对象事务,也可能有全局二级索引,其中索引项和主数据位于不同节点。大多数“NoSQL”分布式数据存储不支持这类分布式事务,但不少分布式关系型数据库支持。
此时,仅仅向所有节点发送提交请求,让每个节点独立提交事务并不够。提交很容易在一部分节点上成功,却在另一部分节点上失败:
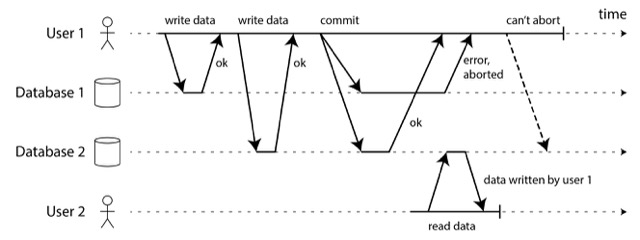
如果有些节点提交、有些节点中止,节点之间便会出现不一致。而事务一旦在某个节点上提交,即便后来发现它在另一个节点上中止,也不能再撤回。因为数据提交后,在 读已提交 或更强隔离下就会对其他事务可见。
好的办法是确保参与事务的节点要么全部提交,要么全部中止,绝不允许两种结果混杂。这就是所谓的 原子提交(atomic commitment)问题。
两阶段提交是一种跨多个节点实现原子事务提交的算法,也是分布式数据库中的经典算法。有些数据库在内部使用 2PC;它也以 XA 事务的形式开放给应用程序。
2PC 的基本流程如图 8-13所示。单节点事务只需一次提交请求,2PC 则把提交或中止过程分成两个阶段,名称也由此而来。
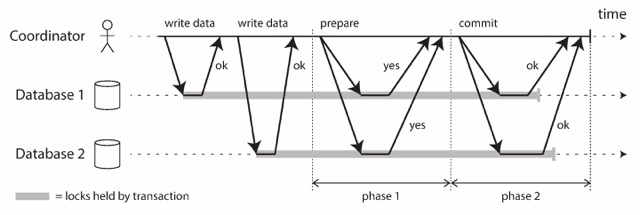
2PC 引入了一个单节点事务中通常没有的组件:协调者(coordinator,也称为 事务管理器,transaction manager) 。协调者通常实现为一个库,与发起事务的应用运行在同一进程中(例如嵌入 Java EE 容器);也可以作为独立进程或服务运行。Narayana、JOTM、BTM 和 MSDTC 都属于此类协调者。
使用 2PC 时,分布式事务照常开市;应用在多个数据库节点上读写数据,这些节点称为事务的 参与者(participant) 。应用准备提交时,协调者进入第一阶段,向每个参与者发送 准备(prepare)请求 ,询问它是否能够提交,并收集各参与者的响应:
这个过程有点像西方传统婚礼:牧师分别询问新娘和新郎是否愿意与对方结婚,通常两人都会回答“我愿意”。收到双方确认后,牧师宣布二人结为夫妻——事务提交,这一喜讯也广播给所有来宾。如果任何一方没有回答“愿意”,仪式就会中止。
要理解 两阶段提交 为何有效,需要把过程进一步拆解:
参与者投 是 时,承诺自己日后一定能够提交;协调者一旦作决定,该决定便不可撤销。
2PC 期间参与者或网络发生故障,任何准备请求失败或超时,协调者都会中止事务;任何提交或中止请求失败,协调者都会无限重试。但协调者自身崩溃时会发生什么,就没那么清楚了。
如果协调者在发送准备请求前失效,参与者可以安全中止事务。但参与者一旦收到准备请求并投出“是”,便不能再单方面中止,必须等待协调者告知事务究竟提交还是中止。如果协调者此时崩溃或网络发生故障,参与者只能等待。这种状态下的事务称为 存疑(in doubt)或 不确定(uncertain)事务 。
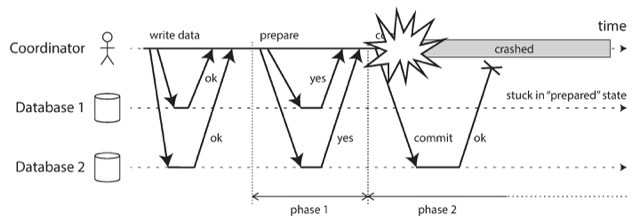
收不到协调者的消息,参与者就无从知道应提交还是中止。原则上,参与者可以相互通信,了解各自如何投票并达成某种协议,但这并不属于 2PC 协议。
完成 2PC 的唯一办法,就是等待协调者恢复。这正是协调者必须先把提交或中止决定写入磁盘事务日志,再向参与者发送请求的原因。协调者恢复后,通过读取事务日志来确定所有存疑事务的状态;协调者日志中没有提交记录的事务一律中止。因此,2PC 的提交点归根结底是协调者上的一次普通单节点原子提交。
由于 2PC 可能卡住并一直等待协调者恢复,两阶段提交也称为 阻塞式(blocking)原子提交协议 。理论上可以设计 非阻塞式(nonblocking)原子提交协议,使它在节点发生故障时不会卡住;但要在实践中做到这一点并不容易。
有人提出 三阶段提交(three-phase commit,3PC)作为 2PC 的替代方案。然而,3PC 假设网络延迟有上界、节点响应时间也有上界;大多数现实系统都存在无界网络延迟和进程暂停,3PC 在其中无法保证原子性。
实践中更好的办法,是用容错共识协议替代单节点协调者。
分布式事务和两阶段提交的名声毁誉参半。一方面,它们提供了难以用其他方式实现的重要安全保证;另一方面,它们又因引发运维问题、严重损害性能,以及作出力所不及的承诺而备受批评。许多云服务正是出于这些运维问题,选择不实现分布式事务。
某些分布式事务实现会带来沉重的性能代价,两阶段提交的固有开销,大多来自崩溃恢复所需的额外强制磁盘 fsync 和 额外网络往返。
数据库内部分布事务:
一些分布式数据库(即标准配置就使用复制和分片的数据库)支持数据库节点之间的内部事务。例如,YugabyteDB、TiDB、FoundationDB、Spanner、VoltDB,以及 MySQL Cluster 的 NDB 存储引擎都支持内部事务。此时,参与事务的所有节点运行的都是同一种数据库软件
异构分布式事务:
异构 事务的参与者来自两种或更多不同技术,例如不同厂商的两种数据库,甚至还包括消息代理等非数据库系统。即使底层系统截然不同,跨系统分布式事务仍必须保证原子提交。
数据库内部事务无须与其他系统兼容,因而可以采用任意协议,并针对具体技术进行优化。所以,数据库内部的分布式事务通常运转良好;跨异构技术的事务则困难得多。
异构分布式事务可以用强有力的方式集成不同系统。例如,当且仅当处理消息的数据库事务成功提交,才确认消息队列中的那条消息已经处理。实现方法是在同一个事务中原子提交 消息确认 和 数据库写入。有了分布式事务,即使消息代理与数据库是运行在不同机器上的两种互不相关的技术,也能做到这一点。
如果消息传递或数据库事务任一失败,两者都会中止,消息代理稍后便可安全地重新投递。通过原子提交消息及其处理副作用,可以确保消息实际上 恰好处理一次,即使成功之前重试了好几次。每次中止都会丢弃未完成事务产生的所有副作用。这就是 恰好一次语义(exactly-once semantics) 。
不过,只有事务影响的所有系统都能采用同一种原子提交协议,这类分布式事务才有可能实现。例如,假设处理消息的副作用是发送邮件,而邮件服务器不支持两阶段提交;一旦消息处理失败并重试,邮件就可能发送两次甚至更多次。反之,如果事务中止时,消息处理产生的所有副作用都能回滚,那么处理过程便可安全重试,就像什么也没有发生一样。
X/Open XA(eXtended Architecture,即扩展架构的缩写)
是跨异构技术实现两阶段提交的标准。
许多传统关系型数据库(包括 PostgreSQL、MySQL、Db2、SQL Server 和 Oracle)和消息代理(包括 ActiveMQ、HornetQ、MSMQ 和 IBM MQ)都支持 XA。
XA 并不是网络协议,而只是一套与事务协调者交互的 C API。其他语言也提供相应绑定。
XA 假定应用通过网络驱动或客户端库,与参与者数据库或消息服务通信。驱动支持 XA,意味着它会调用 XA API,判断某项操作是否属于分布式事务;若是,就把必要信息发送给数据库服务器。驱动还会暴露回调接口,供协调者要求参与者准备、提交或中止。
事务协调者负责实现 XA API。标准没有规定具体实现方式;实践中,协调者通常只是一个加载到事务发起应用同一进程中的库,而不是独立服务。它跟踪事务中的所有参与者,要求它们准备后通过驱动回调收集响应,并用本地磁盘日志记录每个事务的提交或中止决定。
如果应用进程崩溃,或运行应用的机器宕机,协调者也会随之消失。所有持有已准备但尚未提交事务的参与者,都会陷入存疑状态。协调者日志位于应用服务器的本地磁盘上,因此必须重启这台服务器,再由协调者库读取日志,恢复各事务的提交或中止结果。之后,协调者才能通过数据库驱动的 XA 回调,要求参与者提交或中止。数据库服务器无法直接联系协调者,因为所有通信都必须经过客户端库。
为什么要如此在意存疑事务?
问题出在 锁 上,读已提交 数据库事务通常会对修改的每一行取得行级独占锁,以防止脏写。如果还要求可串行化隔离,那么采用两阶段锁定的数据库也必须为事务 读取 的每一行取得共享锁。
事务提交或中止之前,数据库不能释放这些锁。所以使用两阶段提交时,事务必须在整个存疑期间持锁。协调者若崩溃后要花 20 分钟重启,锁就会持有 20 分钟;协调者日志若因故彻底丢失,锁甚至会永远保留 至少要一直等到管理员手动解决问题。
持锁期间,其他事务无法修改这些行;视隔离级别而定,甚至连读取也可能被阻塞。因此,其他事务无法若无其事地继续运行 只要访问同一份数据,就会卡住。应用程序的大部分功能都可能因此不可用,直至存疑事务得到解决。
理论上,协调者崩溃重启后,应该能从日志完整恢复状态,并解决所有存疑事务。但实践中确实会出现 孤立的 存疑事务 :协调者由于某种原因无法确定事务结果,例如软件缺陷导致事务日志丢失或损坏。这些事务无法自动解决,只能一直留在数据库中,持有锁并阻塞其他事务。
重启数据库服务器也解决不了问题。正确的 2PC 实现必须跨重启保留存疑事务的锁,否则就有破坏原子性保证的风险。这种局面十分棘手。
唯一的出路,是由管理员手动决定提交还是回滚。管理员必须检查每个存疑事务的所有参与者,确定是否已有参与者提交或中止,再把同样的结果应用到其余参与者。这项工作可能耗费大量人力,而且往往要在严重生产中断期间,承受巨大的精神与时间压力来完成 否则协调者也不会陷入如此糟糕的状态。
许多 XA 实现都留有一个称为 启发式决策(heuristic decision) 的紧急出口:即使协调者没有给出明确决定,也允许参与者单方面中止或提交存疑事务。需要直说的是,这里的“启发式”只是“很可能破坏原子性”的委婉说法,因为它违背了两阶段提交的承诺体系。因此,启发式决策只用于摆脱灾难性局面,绝不能作为常规手段。
单节点协调者是整个系统的单点故障。把协调者放进应用服务器同样有问题,因为协调者本地磁盘上的日志会成为持久系统状态的关键部分,其重要性不亚于数据库本身。
原则上,XA 事务的协调者可以像其他重要数据库一样实现高可用和复制。遗憾的是,这仍解决不了 XA 的一个根本问题:它没有提供协调者与事务参与者直接通信的办法。二者只能通过发起事务的应用代码,以及应用用来调用参与者的数据库驱动进行通信。
因此,即使复制了协调者,应用代码依然是单点故障。要解决这个问题,必须彻底重构应用代码的运行方式,使其可复制或可重启,形式上可能类似持久化执行。但实践中似乎没有工具真正采用这种方案。
另一个问题是,XA 必须兼容形形色色的数据系统,因而只能取它们的最低公分母。例如,它无法检测横跨不同系统的死锁,因为这需要一套标准协议,让系统交换每个事务正在等待哪些锁;它也无法配合 SSI 使用,因为 SSI 需要一套跨系统识别冲突的协议。
这些问题在一定程度上是跨异构技术执行事务的固有困难。然而,让多个异构数据系统彼此保持一致仍是一个真实而重要的需求,所以必须另寻解决方案。办法的确存在,下一节和“衍生数据与分布式事务” 将作介绍。
横跨多种异构存储技术的分布式事务,与系统内部的分布式事务大不相同。在后者中,所有参与节点都是同一数据库的分片,运行相同软件。
内部的分布式事务是 CockroachDB、TiDB、Spanner、FoundationDB 和 YugabyteDB 等“NewSQL”数据库的标志性特征。Kafka 等消息代理也支持内部的分布式事务。
这些系统中有许多使用两阶段提交,来保证写入多个分片的事务具备原子性,却不会遇到 XA 事务的那些问题。因为其分布式事务无须对接其他技术,所以能够避开最低公分母陷阱;系统设计者可以自由采用更可靠、更快速的协议。
XA 最严重的几个问题可以这样解决:
协调者和数据库分片通常采用共识算法复制。用共识算法实现分布式事务的原子提交。这些算法无需人工干预,就能自动从发生故障的节点切换到另一个节点,在容忍故障的同时继续保证强一致性属性。
分布式事务提供哪种隔离级别,取决于具体系统;但跨分片实现快照隔离和可串行化快照隔离都是可行的。
恰好一次消息处理,分布式事务的一个重要用途,是保证某项操作恰好生效一次,即使处理期间发生崩溃、不得不重试也不例外。如果能跨消息代理和数据库原子提交事务,就可以做到:当且仅当消息成功处理、处理产生的数据库写入也成功提交时,才向代理确认消息。
不过,要实现恰好一次语义,其实并不需要这样的分布式事务。下面的替代方案只要求数据库本身支持事务:
实现恰好一次处理只需要数据库内部的事务;这个用例并不要求数据库与消息代理之间具备原子性。把消息 ID 记入数据库,可以让消息处理具备 幂等性(idempotence) ,因而能够安全重试而不重复产生副作用。Kafka Streams 等流处理框架也用类似办法实现恰好一次语义。
不过,数据库内部的分布式事务仍有助于扩展这类模式。例如,消息 ID 可以存放在一个分片上,消息处理所更新的业务数据放在其他分片上,再由内部事务保证跨分片提交的原子性。
| 隔离级别 | 脏读 | 读偏差 | 幻读 | 丢失更新 | 写偏差 |
|---|---|---|---|---|---|
| 读未提交 | ✗ 可能 | ✗ 可能 | ✗ 可能 | ✗ 可能 | ✗ 可能 |
| 读已提交 | ✓ 防止 | ✗ 可能 | ✗ 可能 | ✗ 可能 | ✗ 可能 |
| 快照隔离 | ✓ 防止 | ✓ 防止 | ✓ 防止 | ? 视情况 | ✗ 可能 |
| 可串行化 | ✓ 防止 | ✓ 防止 | ✓ 防止 | ✓ 防止 | ✓ 防止 |
这么多他妈的怎么记得住?
| 类别 | 异常 | 谁负责 |
|---|---|---|
| “读错了” | 脏读、读偏差 | 隔离级别本身(RC/RR 默认就挡住了) |
| “先查后写,前提失效” | 丢失更新、写偏差、幻读型写偏差 | 隔离级别帮不了你,必须人为处理 |
而第二堆全部是同一个句式:事务先读 → 基于读到的值做决定 → 再写入,期间世界被别人改了。所以真正需要内化的军规只有一条:
凡“先查后写”的代码,问一句:并发时,我查出来的前提还成立吗?不确定 → 四选一:改原子 SQL / FOR UPDATE / 唯一索引 / 队列串行。
再加三条辅助规则(“禁止”类比“理解”类好记得多):
MySQL InnoDB, 读未提交 READ UNCOMMITTED、读已提交 READ COMMITTED、快照隔离 REPEATABLE READ(默认)读走 MVCC 快照,锁定走 next-key 锁、可串行化 SERIALIZABLE。
-- 环境:MySQL 8.0 / InnoDB,两个终端(会话A、会话B)
CREATE DATABASE iso_demo; USE iso_demo;

CREATE TABLE accounts (id INT PRIMARY KEY, holder VARCHAR(20), balance INT) ENGINE=InnoDB;
INSERT INTO accounts VALUES (1,'Alice',1000),
                            (2,'Bob',500);

CREATE TABLE doctors (id INT PRIMARY KEY, name VARCHAR(20), on_call TINYINT) ENGINE=InnoDB;
INSERT INTO doctors VALUES (1,'Alice',1),
                           (2,'Bob',1);

CREATE TABLE counter (id INT PRIMARY KEY, val INT) ENGINE=InnoDB;
INSERT INTO counter VALUES (1,100);

-- 每个实验前重置数据
TRUNCATE accounts; INSERT INTO accounts VALUES (1,'Alice',1000),(2,'Bob',500);
TRUNCATE doctors; INSERT INTO doctors VALUES (1,'Alice',1),(2,'Bob',1);
TRUNCATE counter; INSERT INTO counter VALUES (1,100);-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
UPDATE accounts SET balance = 800 WHERE id = 1; -- 未提交
-- ② 会话B
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT balance FROM accounts WHERE id = 1; -- 输出 800 ← 脏读!
-- ③ 会话A
ROLLBACK; -- A 放弃修改
-- ④ 会话B再读
SELECT balance FROM accounts WHERE id = 1; -- 输出 1000,之前的 800 是"幻觉"B 基于从未存在过的 800 做出的转账/扣减决策全部错误。
解决:读的一方使用 RC 及以上(MVCC 快照只看已提交数据)。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT balance FROM accounts WHERE id = 1;   -- Alice=1000

-- ② 会话B(完成一笔转账:Alice→Bob 500)
BEGIN;
UPDATE accounts SET balance = 500  WHERE id = 1;
UPDATE accounts SET balance = 1000 WHERE id = 2;
COMMIT;

-- ③ 会话A再读另一半
SELECT balance FROM accounts WHERE id = 2;   -- Bob=1000
-- A 看到 (1000, 1000),总和 2000 ≠ 1500,转账前后两个状态被拼接
解决:RR(事务级快照,整个事务看到同一时刻的一致状态)。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 2

-- ② 会话B
BEGIN; INSERT INTO doctors VALUES (3,'Carol',1); COMMIT;

-- ③ 会话A
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 3 ← 多了一行(幻影行)
解决:RR 的快照读天然看不到新提交的行 见 #13。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT val FROM counter WHERE id = 1;   -- 100(应用计算 100-30=70)

-- ② 会话B 并发
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT val FROM counter WHERE id = 1;   -- 100(应用计算 100-20=80)

-- ③ A 先写
UPDATE counter SET val = 70 WHERE id = 1;   -- 写绝对值
COMMIT;

-- ④ B 后写(会等 A 的行锁,但提交后照样覆盖)
UPDATE counter SET val = 80 WHERE id = 1;
COMMIT;

SELECT val FROM counter WHERE id = 1;   -- 80 ❌ 应为 50,A 扣的 30 丢了
解决(四选一):
-- 方案1:原子相对更新(首选)
UPDATE counter SET val = val - 30 WHERE id = 1;

-- 方案2:悲观锁
SELECT val FROM counter WHERE id = 1 FOR UPDATE;   -- 当前读+X锁

-- 方案3:乐观锁 CAS
UPDATE counter SET val = 70 WHERE id = 1 AND val = 100;
SELECT ROW_COUNT();   -- 0 说明有并发修改 → 重试

-- 方案4:SERIALIZABLE-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1; -- 2 ≥ 2,我可以下班
-- ② 会话B 并发做同样判断
SET SESSION TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1; -- 2,我也可以下班
-- ③ 各自更新【不同的行】→ 无锁冲突
UPDATE doctors SET on_call = 0 WHERE id = 1; COMMIT; -- A
UPDATE doctors SET on_call = 0 WHERE id = 2; COMMIT; -- B
SELECT COUNT(*) FROM doctors WHERE on_call = 1; -- 0 ❌ 无人值班!两人读取时都没错,但决策前提在写入时已失效;因为写的是不同行,行锁根本挡不住。
解决:见 #15(SERIALIZABLE / 锁定读 / 物化冲突)。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
UPDATE accounts SET balance = 800 WHERE id = 1;   -- 未提交

-- ② 会话B
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT balance FROM accounts WHERE id = 1;   -- 输出 1000 ✅ 看不到 800

-- ③ 会话A
ROLLBACK;
机制:普通 SELECT 走 MVCC,每条语句读”语句开始前已提交”的快照,未提交数据不可见。
流程与 #2 完全相同,仅把 A 改为 RC。结果一样:A 先读 Alice=1000,B 提交转账后,A 读 Bob=1000(每条语句都是新快照),看到 (1000, 1000) 的不一致拼接。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT balance FROM accounts WHERE id = 1;   -- Alice=1000

-- ② 会话B(完成一笔转账:Alice→Bob 500)
BEGIN;
UPDATE accounts SET balance = 500  WHERE id = 1;
UPDATE accounts SET balance = 1000 WHERE id = 2;
COMMIT;

-- ③ 会话A再读另一半
SELECT balance FROM accounts WHERE id = 2;   -- Bob=1000
-- A 看到 (1000, 1000),总和 2000 ≠ 1500,转账前后两个状态被拼接
解决:RR;或 A 用 FOR SHARE 锁住已读的行;或业务上单条语句读齐相关行。
-- ① 会话A(RC)
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 2

-- ② 会话B
BEGIN; INSERT INTO doctors VALUES (3,'Carol',1); COMMIT;

-- ③ 会话A
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 3 ❌ 幻读
解决:RR(快照读);若需”禁止别人插入”,必须 RR + FOR UPDATE 或 SERIALIZABLE。
流程与 #4 完全相同,两个会话改为 RC。结果一样是 80 ❌。RC 的快照虽比 RU”新”,但两个事务并发读到同一个旧值的窗口依然存在,且 MySQL 不提供”先提交者获胜”报错。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT val FROM counter WHERE id = 1;   -- 100(应用计算 100-30=70)

-- ② 会话B 并发
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT val FROM counter WHERE id = 1;   -- 100(应用计算 100-20=80)

-- ③ A 先写
UPDATE counter SET val = 70 WHERE id = 1;   -- 写绝对值
COMMIT;

-- ④ B 后写(会等 A 的行锁,但提交后照样覆盖)
UPDATE counter SET val = 80 WHERE id = 1;
COMMIT;

SELECT val FROM counter WHERE id = 1;   -- 80 ❌ 应为 50,A 扣的 30 丢了
解决(四选一)同 #4:
-- 方案1:原子相对更新(首选)
UPDATE counter SET val = val - 30 WHERE id = 1;

-- 方案2:悲观锁
SELECT val FROM counter WHERE id = 1 FOR UPDATE;   -- 当前读+X锁

-- 方案3:乐观锁 CAS
UPDATE counter SET val = 70 WHERE id = 1 AND val = 100;
SELECT ROW_COUNT();   -- 0 说明有并发修改 → 重试

-- 方案4:SERIALIZABLE流程与 #5 相同,改为 RC,结果一样 0 人值班 ❌。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 2 ≥ 2,我可以下班

-- ② 会话B 并发做同样判断
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 2,我也可以下班

-- ③ 各自更新【不同的行】→ 无锁冲突
UPDATE doctors SET on_call = 0 WHERE id = 1;  COMMIT;   -- A
UPDATE doctors SET on_call = 0 WHERE id = 2;  COMMIT;   -- B

SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 0 ❌ 无人值班!
注意:RC 下即使用 FOR UPDATE 做检查,没有间隙锁,只锁已存在的行——防不住”插入型”写偏差(见 #15 的报名示例)。
解决:见 #15。
同 #6 流程,B 改为 RR:读到 1000 ✅。且 B 事务内即使 A COMMIT 后再读,仍是 1000(快照固定)。要看新值需开新事务或用锁定读。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
BEGIN;
UPDATE accounts SET balance = 800 WHERE id = 1;   -- 未提交

-- ② 会话B
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
BEGIN;
SELECT balance FROM accounts WHERE id = 1;   -- 输出 1000 ✅ 看不到 800

-- ③ 会话A
ROLLBACK;-- ① 会话A(RR)
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
BEGIN;
SELECT balance FROM accounts WHERE id = 1; -- 1000(事务快照在第一条读建立)
-- ② 会话B 完成转账并提交(500 / 1000)
-- ③ 会话A
SELECT balance FROM accounts WHERE id = 1; -- 1000(不变)
SELECT balance FROM accounts WHERE id = 2; -- 500(不变)
-- 总和恒为 1500 ✅ —— 读到的是"陈旧但一致"的快照-- ① 会话A(RR)
BEGIN;
SELECT COUNT(*) FROM doctors; -- 2
-- ② 会话B
BEGIN; INSERT INTO doctors VALUES (3,'Carol',1); COMMIT;
-- ③ 会话A 普通读
SELECT COUNT(*) FROM doctors; -- 仍然 2 ✅ 新行对快照不可见坑 1:当前读会”戳破”快照
-- ④ 会话A 执行当前读类语句
UPDATE doctors SET name='Carol*' WHERE id = 3;   -- 当前读能看到B提交的新行,更新成功
SELECT COUNT(*) FROM doctors;   -- 3 ← 自己修改过的行对快照可见,幻影"浮现"
⚠️ 坑 2:快照防幻读 ≠ 防止别人插入。若业务需要”查询期间禁止插入”(写偏差场景),需要 RR + FOR UPDATE(next-key 锁)或 SERIALIZABLE —— 这正是脚注中”写偏差场景中的幻读需要索引范围锁”的含义。
情况 A:不会丢 —— 单条相对值更新
-- 会话A(RR)
BEGIN; UPDATE counter SET val = val - 30 WHERE id = 1; COMMIT;
-- 会话B 同时
BEGIN; UPDATE counter SET val = val - 20 WHERE id = 1;   -- 阻塞等A的行锁
COMMIT;
SELECT val FROM counter WHERE id = 1;   -- 50 ✅(B的当前读基于最新值 70 计算)
情况 B:会丢 —— 应用层”读→算→写绝对值”(ORM 的 read→modify→save 就是这个)
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
BEGIN;
SELECT val FROM counter WHERE id = 1;   -- 100(快照读,无锁)→ 算出 70
-- ② 会话B 同样读到 100 → 算出 80
-- ③ A: UPDATE counter SET val = 70 WHERE id = 1; COMMIT;
-- ④ B: UPDATE counter SET val = 80 WHERE id = 1; COMMIT;
SELECT val FROM counter;   -- 80 ❌
所以判断口诀:写相对增量 → 安全;写应用算好的绝对值 → 丢。教科书 SI 靠”先更新者获胜”报错防护,MySQL RR 不报错、静默覆盖。
解决:FOR UPDATE 悲观锁,或 UPDATE … WHERE val=100 的 CAS(检查 ROW_COUNT()),或改写为相对值 SQL,或 SERIALIZABLE。
流程与 #5 相同,改为 RR,结果一样 0 人值班 ❌ —— RR 的普通 SELECT 是快照读不加任何锁,InnoDB 无法察觉两个事务的读写冲突。
-- ① 会话A
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
BEGIN;

-- ② 会话B
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
BEGIN;

-- ① 会话A
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 2 ≥ 2,我可以下班

-- ② 会话B
SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 2,我也可以下班

-- ③ 各自更新【不同的行】→ 无锁冲突
UPDATE doctors SET on_call = 0 WHERE id = 1;  COMMIT;   -- A
UPDATE doctors SET on_call = 0 WHERE id = 2;  COMMIT;   -- B

SELECT COUNT(*) FROM doctors WHERE on_call = 1;   -- 0 ❌ 无人值班!
解决 1:显式锁定读(RR 下 next-key 锁)
-- 会话A
BEGIN;
SELECT COUNT(*) FROM doctors WHERE on_call = 1 FOR UPDATE;   -- 2,锁定匹配行+间隙
UPDATE doctors SET on_call = 0 WHERE id = 1;
COMMIT;
-- 会话B:同样的 FOR UPDATE 会阻塞到 A 提交,然后读到 1 → 放弃下班 ✅
(前提:所有下班事务都走这条锁定检查;无索引时会锁全表所有记录+间隙,等价锁表)
解决 2:物化冲突(任意隔离级别都安全,推荐)
CREATE TABLE shift_stat (shift_id INT PRIMARY KEY, on_call_cnt INT NOT NULL);
INSERT INTO shift_stat VALUES (1, 2);

-- 下班事务:
BEGIN;
UPDATE shift_stat SET on_call_cnt = on_call_cnt - 1
  WHERE shift_id = 1 AND on_call_cnt > 1;
-- ROW_COUNT()=0 → 已有人先走 → ROLLBACK ✅(B会阻塞在行锁上,A提交后条件不成立)
解决 3:幻读型写偏差(如”名额上限 3 人”)—— RC 下 FOR UPDATE 也防不住,必须范围锁
CREATE TABLE signups (id INT PRIMARY KEY AUTO_INCREMENT, slot INT, KEY idx_slot(slot));
INSERT INTO signups (slot) VALUES (5),(5);   -- 已 2 人,上限 3
-- A、B 都快照读 COUNT=2 → 都 INSERT 成功 → 4 人 ❌ 超限
-- 修复:RR + SELECT COUNT(*) ... WHERE slot=5 FOR UPDATE(idx_slot 范围锁,
-- B 阻塞后看到 3 → 放弃),或用上面的计数器物化方案机制:RR 的锁机制 + 事务内普通 SELECT 自动变成 FOR SHARE(共享锁当前读)。 代价:并发大幅下降、死锁频繁,应用必须捕获 ERROR 1213 (40001) 并重试。
-- ① 会话A(SER)
SET SESSION TRANSACTION ISOLATION LEVEL SERIALIZABLE;
BEGIN;
UPDATE accounts SET balance = 800 WHERE id = 1;   -- 持 X 锁未提交

-- ② 会话B(SER)
BEGIN;
SELECT balance FROM accounts WHERE id = 1;   -- ⏸ 阻塞(等 A 的 X 锁)
-- ③ A: ROLLBACK → B 解除阻塞读到 1000;若 A: COMMIT → B 读到 800
无论 A 提交还是回滚,B 永远读不到未提交值 ✅。
-- ① 会话A(SER)
BEGIN; SELECT balance FROM accounts WHERE id=1;  -- 1000(并加S锁)

-- ② 会话B:
BEGIN; UPDATE accounts SET balance=500 WHERE id=1;    -- ⏸ 阻塞!

-- ③ 会话A:
SELECT balance FROM accounts WHERE id=2;              -- 500
COMMIT;   -- A提交后B才解除阻塞继续转账
A 读过的行被 S 锁保护,别人的修改进不来 → 全程读到一致状态 ✅(与 #12 不同:读到的是”最新已提交”而非旧快照)。
-- ① 会话A(SER)
BEGIN; SELECT COUNT(*) FROM doctors WHERE on_call=1;  -- 2(锁定行+间隙)

-- ② 会话B:
BEGIN; INSERT INTO doctors VALUES (3,'Carol',1);  -- ⏸ 阻塞(插入意向锁等间隙锁)

-- ③ 会话A:
SELECT COUNT(*) ...;  -- 仍 2;COMMIT 后 B 的插入才成功 ✅
(等待超过 innodb_lock_wait_timeout(默认 50s)会报 ERROR 1205)
-- ① A(SER):
BEGIN; SELECT val FROM counter WHERE id=1;   -- 100(S锁)

-- ② A:
UPDATE counter SET val=70 WHERE id=1;             -- 成功(S→X)

-- ③ B(SER):
BEGIN; SELECT val FROM counter WHERE id=1;   -- ⏸ 等A提交 → 读到 70
--           应用重新计算 70-20=50;
UPDATE ... SET val=50; COMMIT;   -- ✅ 50
若 A、B 先都读后都写:双方互持对方需要的 S 锁 → ERROR 1213 死锁,一方被回滚 → 重试后读到新值再计算,同样不丢 ✅。
-- ① A(SER):
BEGIN; SELECT COUNT(*) FROM doctors WHERE on_call=1;  -- 2(S锁)

-- ② B(SER):
BEGIN; SELECT COUNT(*) ...;                           -- 2(S锁,兼容)

-- ③ A:
UPDATE doctors SET on_call=0 WHERE id=1;   -- ⏸ 等B的S锁

-- ④ B:
UPDATE doctors SET on_call=0 WHERE id=2;   -- ⏸ 等A的S锁

--    → ERROR 1213 (40001): Deadlock found... → B 被回滚,A 提交

-- ⑤ B 重试:SELECT COUNT(*) → 1 → 不满足"≥2才能下班" → 放弃 ✅ 约束保持
MySQL 防写偏差的现实就是”死锁回滚 + 应用重试”——不写重试逻辑,业务会收到报错。